Độ lệch chuẩn (Standard Deviation) là một chỉ số thống kê phản ánh mức độ phân tán của các giá trị trong một tập dữ liệu so với giá trị trung bình (Mean). Nói cách khác, chỉ số này cho biết các quan sát lệch xa hay gần trung bình đến mức nào. Trong các phần mềm phân tích thống kê, độ lệch chuẩn thường được ký hiệu là S.D hoặc Std. Deviation.
1. Độ lệch chuẩn (Standard Deviation) là gì?
1.1 Khái niệm độ lệch chuẩn
Độ lệch chuẩn (Standard Deviation) là một chỉ số thống kê phản ánh mức độ phân tán hay biến động của các giá trị trong một tập dữ liệu so với giá trị trung bình (mean). Nói cách khác, chỉ số này cho biết các quan sát trong dữ liệu phân bố rộng hay hẹp quanh giá trị trung bình.
Khi phân tích dữ liệu, độ lệch chuẩn giúp nhà nghiên cứu hiểu được mức độ đồng đều của câu trả lời hoặc kết quả đo lường. Nếu các giá trị nằm sát nhau quanh trung bình, dữ liệu có tính ổn định cao. Ngược lại, nếu các giá trị chênh lệch lớn, dữ liệu có sự biến động mạnh.
Trong các phần mềm thống kê như SPSS, AMOS, SMARTPLS, độ lệch chuẩn thường xuất hiện trong bảng Descriptive Statistics cùng với các chỉ số như Mean, Minimum, Maximum,… nhằm cung cấp cái nhìn tổng quan về đặc điểm phân phối của dữ liệu trước khi thực hiện các phân tích chuyên sâu hơn.
1.2 Công thức tính độ lệch chuẩn
Công thức tính độ lệch chuẩn như sau:
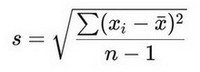
Trong đó:
- s: Độ lệch chuẩn mẫu
- xi: Giá trị quan sát thứ i
- xˉ: Giá trị trung bình mẫu
- n: Cỡ mẫu
- n−1: Bậc tự do (degrees of freedom)
Điểm trọng tâm cần ghi nhớ:
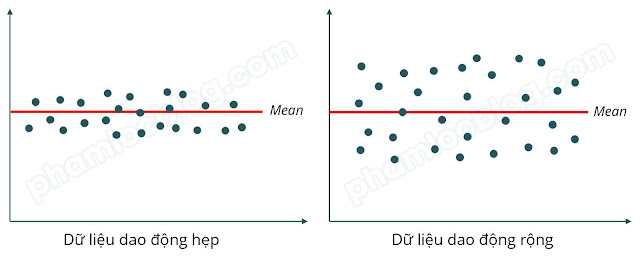
- Độ lệch chuẩn càng lớn thì mức độ phân tán của dữ liệu càng cao, nghĩa là các giá trị càng cách xa trung bình.
- Độ lệch chuẩn càng nhỏ thì dữ liệu càng tập trung quanh trung bình, thể hiện mức độ ổn định hoặc đồng nhất cao hơn.
Ví dụ minh họa: Giả sử bạn thu thập điểm thi môn Toán của 100 sinh viên. Nếu phần lớn điểm số tập trung trong khoảng 7–8 và chỉ có một vài trường hợp lệch nhẹ, độ lệch chuẩn sẽ nhỏ. Ngược lại, nếu điểm số trải dài từ 3 đến 10 với sự chênh lệch lớn giữa các sinh viên, độ lệch chuẩn sẽ cao, phản ánh mức độ phân tán mạnh của dữ liệu.
1.3 Tại sao độ lệch chuẩn lại quan trọng?
Độ lệch chuẩn là một trong những chỉ số thống kê quan trọng nhất vì nó phản ánh mức độ phân tán của dữ liệu quanh giá trị trung bình. Không chỉ dừng lại ở vai trò mô tả, độ lệch chuẩn còn là nền tảng cho rất nhiều phân tích nâng cao trong nghiên cứu và thực tiễn.
Thứ nhất, thể hiện mức độ biến động của dữ liệu
Độ lệch chuẩn cho biết dữ liệu có ổn định hay không.
Nếu độ lệch chuẩn nhỏ, các giá trị quan sát nằm gần trung bình, nghĩa là dữ liệu đồng nhất và ít biến động. Ngược lại, nếu độ lệch chuẩn lớn, dữ liệu phân tán rộng, thể hiện sự khác biệt đáng kể giữa các quan sát.
Ví dụ trong khảo sát Likert 1–5:
- Nếu Mean = 4.2 và SD = 0.6 → người trả lời có xu hướng đồng thuận và khá thống nhất.
- Nếu Mean = 4.2 nhưng SD = 1.4 → mặc dù trung bình cao, nhưng có sự chia rẽ mạnh giữa các nhóm đáp viên.
Vì vậy, chỉ nhìn Mean là chưa đủ, cần xem thêm SD để hiểu bản chất dữ liệu.
Thứ hai, dễ hiểu và dễ diễn giải
So với phương sai (variance), độ lệch chuẩn có ưu điểm lớn là cùng đơn vị đo với dữ liệu ban đầu.
Ví dụ: Nếu dữ liệu là điểm số (thang 1–5), thì độ lệch chuẩn cũng nằm trong khoảng đó. Trong khi phương sai lại là đơn vị bình phương (ví dụ 1.44), khiến việc diễn giải kém trực quan.
Chính vì vậy, trong báo cáo học thuật và thực hành SPSS, người ta thường trình bày: Mean ± SD. Ví dụ: 3.85 ± 0.72. Cách trình bày này giúp người đọc hình dung ngay mức độ trung tâm và mức độ phân tán.
Thứ ba, hỗ trợ đánh giá phân phối dữ liệu
Trong phân phối chuẩn (normal distribution), độ lệch chuẩn đóng vai trò trung tâm trong việc xác định tỷ lệ dữ liệu nằm trong các khoảng nhất định:
- Khoảng ±1 SD chứa khoảng 68% dữ liệu
- Khoảng ±2 SD chứa khoảng 95% dữ liệu
- Khoảng ±3 SD chứa khoảng 99.7% dữ liệu
Quy tắc này (quy tắc 68–95–99.7) giúp:
- Phát hiện giá trị ngoại lệ (outliers)
- Đánh giá dữ liệu có gần phân phối chuẩn hay không
- Xác định mức độ bất thường trong dữ liệu
Trong thực tế nghiên cứu, nếu một quan sát nằm ngoài ±3 SD, nó thường được xem là giá trị bất thường và cần kiểm tra lại.
Thứ tư, nền tảng cho các kiểm định học thuật
Độ lệch chuẩn không chỉ dùng để mô tả, mà còn là cơ sở cho rất nhiều phép kiểm định thống kê:
- Kiểm định t-test
- ANOVA
- Hồi quy tuyến tính
- Phân tích SEM
- Tính hệ số tin cậy như Cronbach’s Alpha
Ví dụ trong kiểm định giả thuyết, công thức thống kê t có dạng: t = (Mean1 − Mean2) / Sai số chuẩn. Mà sai số chuẩn lại được tính dựa trên độ lệch chuẩn. Điều này cho thấy: nếu không có độ lệch chuẩn, gần như không thể thực hiện các kiểm định suy luận thống kê.
3. Độ lệch chuẩn bao nhiêu là tốt?
Câu trả lời là: không có một ngưỡng cố định nào để kết luận độ lệch chuẩn là “tốt”, “xấu”, “đạt” hay “vi phạm”.
Lý do là vì độ lệch chuẩn không tự thân mang ý nghĩa đánh giá, mà chỉ phản ánh mức độ biến động của dữ liệu. Việc nó tốt hay không phụ thuộc hoàn toàn vào bối cảnh nghiên cứu và mục tiêu phân tích.
Thứ nhất, độ lệch chuẩn phụ thuộc vào đặc thù của dữ liệu. Mỗi lĩnh vực có bản chất khác nhau nên mức độ dao động chấp nhận được cũng khác nhau. Ví dụ, độ lệch chuẩn của điểm thi sẽ khác hoàn toàn độ lệch chuẩn của thời gian giao hàng hoặc thu nhập hàng tháng.
Thứ hai, không thể so sánh độ lệch chuẩn giữa các bộ dữ liệu có đơn vị đo khác nhau. Điểm số (thang 1–10), thời gian (phút), tiền tệ (triệu đồng)… đều có đơn vị riêng. Vì vậy, việc nói “SD = 1 là cao hay thấp” chỉ có ý nghĩa khi đặt trong đúng bối cảnh dữ liệu đó.
Thứ ba, cùng một giá trị độ lệch chuẩn có thể được xem là chấp nhận được trong nghiên cứu này nhưng lại bị coi là biến động quá lớn trong nghiên cứu khác. Tất cả phụ thuộc vào kỳ vọng của nhà nghiên cứu và nền tảng lý thuyết ban đầu.
Quan trọng nhất: độ lệch chuẩn không đánh giá tốt hay xấu, nó chỉ đo lường độ phân tán. Việc đánh giá phụ thuộc vào mục tiêu nghiên cứu.
Ví dụ với thang đo Likert 5 mức độ đồng ý:
Giả sử bạn có một câu hỏi đo bằng thang Likert 1–5.
Trường hợp 1: Bạn kỳ vọng sự ổn định và đồng thuận
Bạn mong đa số đáp viên chọn mức 3, 4 hoặc 5 (nghiêng về đồng ý), thay vì phân tán đều từ 1 đến 5. Nếu cùng một nhóm đối tượng có đặc điểm tương đồng nhưng có người chọn rất cao (4–5), người lại chọn rất thấp (1–2), thì dữ liệu sẽ phân tán mạnh. Khi đó, độ lệch chuẩn tăng cao.
Trong bối cảnh bạn kỳ vọng sự đồng nhất, độ lệch chuẩn cao là điều không mong muốn, vì nó cho thấy mức độ trả lời thiếu ổn định so với giả thuyết hoặc cơ sở lý thuyết ban đầu.
Trường hợp 2: Bạn kỳ vọng sự khác biệt giữa các nhóm
Ngược lại, nếu mục tiêu của bạn là so sánh sự khác biệt giữa các nhóm (ví dụ nam – nữ, trẻ – lớn tuổi), bạn kỳ vọng các nhóm sẽ có xu hướng trả lời khác nhau rõ rệt.
Tuy nhiên, nếu tất cả đáp viên đều trả lời khá giống nhau, chủ yếu quanh mức 3–4–5 và ít có sự chênh lệch, thì dữ liệu trở nên “đồng đều”, thiếu biến động. Khi đó, độ lệch chuẩn thấp lại không phải tín hiệu tốt, vì nó không phản ánh được sự khác biệt mà bạn mong muốn phát hiện.
4. Khi nào độ lệch chuẩn được coi là “lớn” hay “nhỏ”?
Mặc dù không có ngưỡng cố định, nhưng có cách để đánh giá tương đối độ biến động thông qua Hệ số biến động (Coefficient of Variation – CV).
CV được xác định theo công thức: CV = (S.D/Mean) × 100%.
Trong đó:
- CV (Coefficient of Variation) là hệ số biến động,
- S.D (Standard Deviation) là độ lệch chuẩn,
- Mean là giá trị trung bình của tập dữ liệu.
Ví dụ, đối với môn Toán của 50 học sinh có điểm trung bình là 6.65 và độ lệch chuẩn là 1.112. Áp dụng công thức trên, hệ số biến động được tính như sau: CV = 1.112/6.65 × 100% = 16.7%.
Hiện nay, chưa tồn tại một ngưỡng đánh giá CV mang tính thống nhất, do chỉ số này chịu ảnh hưởng đáng kể bởi đặc điểm của từng lĩnh vực nghiên cứu cũng như mục tiêu phân tích cụ thể. Trong ấn phẩm Classification of the coefficients of variation of parameters evaluated in Japanese quail experiments (2014), đăng trên Braz. J. Poult, tác giả có đề cập đến hệ thống phân loại CV do Gomes (2000) đề xuất trong bối cảnh nghiên cứu thực nghiệm trên chim cút Nhật Bản, bao gồm:
- CV < 10%: mức thấp
- 10% ≤ CV < 20%: mức trung bình
- 20% ≤ CV < 30%: mức cao
- CV ≥ 30%: mức rất cao
5. Độ lệch chuẩn trong thang đo Likert 1–5
Trong các nghiên cứu sử dụng thang đo Likert 1–5, ngoài giá trị trung bình (Mean), độ lệch chuẩn (Standard Deviation – SD) là chỉ số không thể thiếu khi phân tích dữ liệu. Nếu Mean phản ánh xu hướng chung của người trả lời (thiên về đồng ý hay không đồng ý), thì SD cho biết mức độ thống nhất hay phân hóa trong các câu trả lời đó. Nói cách khác, Mean cho biết “mức độ”, còn SD cho biết “mức độ đồng thuận”.
Với thang đo Likert 1–5 (1 = Hoàn toàn không đồng ý, 5 = Hoàn toàn đồng ý), giá trị độ lệch chuẩn chỉ dao động trong một phạm vi nhất định vì dữ liệu bị giới hạn từ 1 đến 5. Khi phần lớn người tham gia chọn các mức điểm gần nhau (ví dụ tập trung ở mức 4), độ lệch chuẩn sẽ nhỏ, thể hiện sự đồng thuận cao. Ngược lại, nếu câu trả lời trải rộng từ 1 đến 5, SD sẽ lớn hơn, phản ánh sự khác biệt đáng kể giữa các quan điểm.
Giả sử khảo sát 150 người với phát biểu: “Tôi hài lòng với dịch vụ”.
- Trường hợp thứ nhất: Mean = 4.2, SD = 0.55
Kết quả này cho thấy đa số người trả lời nghiêng về mức “Đồng ý” hoặc “Hoàn toàn đồng ý”. Độ lệch chuẩn thấp chứng tỏ các ý kiến khá tập trung và mức độ đồng thuận cao.
- Trường hợp thứ hai: Mean = 3.8, SD = 1.20
Mặc dù giá trị trung bình vẫn ở mức tương đối tích cực, nhưng SD lớn cho thấy tồn tại sự phân hóa trong mẫu khảo sát. Có thể có nhóm rất hài lòng (chọn 4–5) và nhóm chưa hài lòng (chọn 1–2), làm cho dữ liệu phân tán mạnh hơn.
Trong thực tiễn nghiên cứu xã hội và quản trị, độ lệch chuẩn của thang Likert 1–5 thường rơi vào khoảng 0.5 đến 1.2. Tuy nhiên, không có một ngưỡng tuyệt đối nào để kết luận SD là tốt hay xấu. Có thể tham khảo tương đối như sau:
- SD < 0.6: Mức độ đồng thuận cao, câu trả lời tập trung nhiều quanh trung bình.
- 0.6 ≤ SD ≤ 1.0: Mức phân tán trung bình, khá phổ biến trong nghiên cứu thực nghiệm.
- SD > 1.0: Mức phân tán lớn, cho thấy ý kiến giữa các đáp viên còn khác biệt đáng kể.
Cần nhấn mạnh rằng SD cao không đồng nghĩa với dữ liệu kém chất lượng. Trong các nghiên cứu mang tính khám phá hoặc nghiên cứu so sánh nhóm, mức độ phân tán cao có thể phản ánh sự tồn tại của nhiều luồng quan điểm khác nhau trong mẫu khảo sát, và đây lại là thông tin quan trọng cho phân tích sâu hơn.
Khi trình bày kết quả trong luận văn hoặc bài báo khoa học, nên báo cáo Mean và SD cùng lúc để đảm bảo tính đầy đủ và rõ ràng. Ví dụ: “Biến HL1 có giá trị trung bình 4.12 và độ lệch chuẩn 0.63, cho thấy người trả lời có xu hướng đồng ý và mức độ đồng thuận tương đối cao.”
Tóm lại, trong thang đo Likert 1–5, độ lệch chuẩn đóng vai trò đánh giá mức độ thống nhất trong nhận thức của người tham gia khảo sát. Việc diễn giải cần đặt trong bối cảnh mục tiêu nghiên cứu cụ thể, tránh đánh giá SD theo hướng tốt – xấu một cách cứng nhắc.
—–
Tài liệu tham khảo:
Braz. J. Poult, Classification of the coefficients of variation of parameters evaluated in Japanese quail experiments, 2014, Brazilian Journal of Poultry Science.
Post Views: 1,186